Qwen3.8-Flash-Next,核心模型 125B 参数,每个 token 激活约 6B,智力与Opus4.6持平。
部署到12GB 显卡,接近 100 tok/s,甚至比 Astra 还快2倍?
使用Strata,大力出奇迹,让 GPU、CPU、RAM 和 SSD 一起干活。
公开测试里,RTX 5070 12GB + 64GB RAM,Q2_0 短对话已经能做到 94 tok/s;128K context 下有 76 tok/s。
这次我不自己敲命令,直接让 Agent 从零部署。
我使用蚂蚁新出的Ling-3.1-flash,这次不是简单代码生成任务,这次是一个*超长流程 Agent 任务*:读文档、检查机器、执行命令、处理报错,再一路跑到最终验收。Ling-3.1-flash有 *560B-A25B、1M 上下文*,重点强化的正是 *Coding 和长流程 Agent*。测试的过程中,上下文会频繁地压缩,非常考验长程任务能否跑出来。
部署完成后,再把本地 Qwen 接回 pi。
这篇不只是教你部署 Qwen,更是跑通一套 Agent 自动部署本地模型的流程。
以后换 Ling、GLM、Kimi、DeepSeek、Minimax H3、Ming都能照这个思路。
0. 导读
- 为什么 12GB 能跑 125B-A6B: 模型结构与 Strata 的基本逻辑
- 同样是量化,速度为什么能差 1.72 倍:推荐阅读
- 让 Ling-3.1-flash + pi 从零部署:检查机器、选权重、下载、安装、排错、测速、接回 pi。
- 为什么能这么快
- 结果与结论,这套用Ling做Agent的部署方法以后怎么复用。
1. 为什么 12GB 能跑 125B-A6B
Qwen3.8-Flash-Next 的参数,125B A6B, 带51B n-gram和4B MTP
125B 是模型核心权重,A6B 表示每生成一个 token,真正参与计算的大约只有 6B 参数。
关键就是这个6B,极其稀疏,能让这个模型在消费级卡上运行。
Flash-Next 每层有 512 个 routed experts,每个 token 只选 10 个,再加 1 个 shared expert;48 层一共有 24,576 个 layer-expert 单元。
Strata 的思路很直接:
常用专家留 GPU,其他专家放 RAM,CPU 处理 cache miss,SSD 保存模型文件和大型查表数据。
它让GPU + CPU + RAM + SSD 一起跑。
显存减少专家miss,RAM 决定能放多少权重,CPU 和内存带宽决定 miss 时有多慢。
2. 同样是量化,速度为什么能差 1.72 倍?
我以前选量化,基本只问两个问题:
精度掉多少?模型能不能装下?
但测完 Strata,最重要问题会变成显存能装多少专家。
我先在同一张 RTX 4090 48GB 上测试了两个 Unsloth Q4 量化,限制GPU的实际占用:
| 项目 | UD-IQ4_XS | UD-Q4_K_XL | | --- | --- | --- | | 权重下载量 | 约 94GB | 约 111GB | | GPU 实际占用 | 39.35GiB | 39.14GiB | | 常驻 expert slots | 17,468 | 13,399 | | 常驻比例 | 71.10% | 54.50% | | 128K decode | 147.7 tok/s | 85.9 tok/s |
最有意思的地方来了:
GPU 占用几乎一样,速度却差了 1.72 倍。
IQ4_XS 多缓存了 4,069 个 layer-expert slots,更多计算留在 GPU,CPU miss 更少。
到了 256K context,两边分别是 82.8 和 73.4 tok/s,差距又缩到约 13%,对应的 expert cache 命中率也开始接近。
所以 Strata 下选量化,不能只看 Q2、Q3、Q4。
真正决定速度的反而是专家命中率。
那到底选哪个?
我又用固定题目测了三份权重:
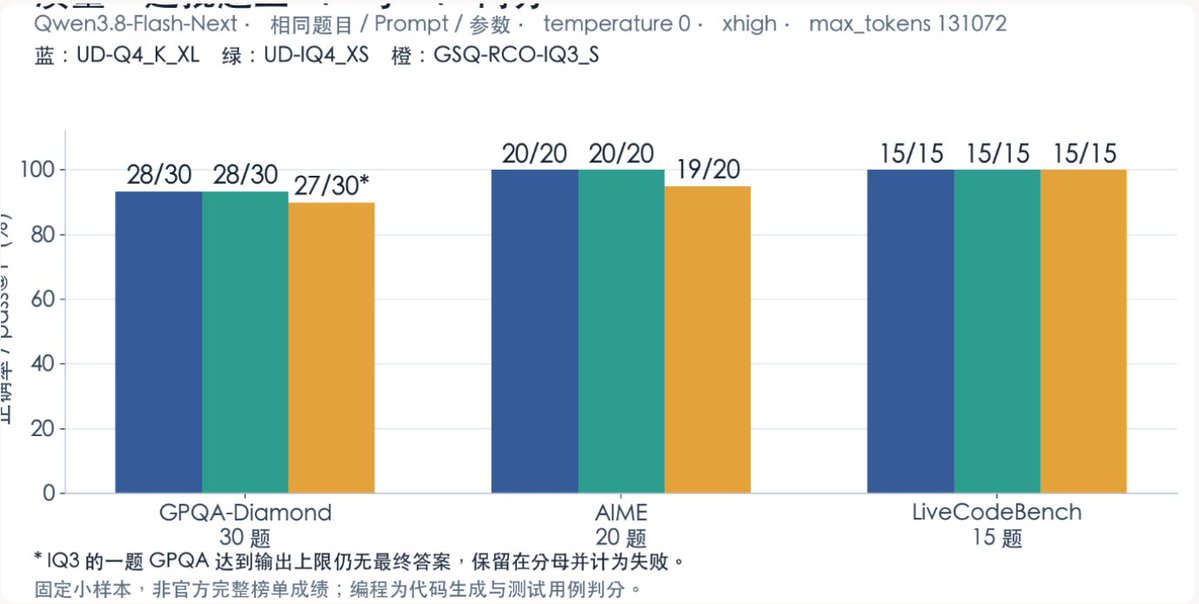
结论很容易出来,在我的48G卡上:
UD-Q4_K_XL:质量最好一点,但最重。 UD-IQ4_XS:平衡,推荐。 IQ3_S:再小一档,质量损失依然很有限。
这也是后面部署时选权重的依据。
如果你是12G的卡,推荐选GSQ-RCO的iQ2/iQ3。
3. 让Ling-3.1-flash从零部署
这次我不自己敲命令。
直接让 Ling-3.1-flash**** 接入 pi****,从零完成:
检查机器 → 选权重 → 下载 → 安装 → 启动 → 排错 → 测速 → 验收。
安装 pi:
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
pi
然后接入Ling-3.1-flash。
接下来把这段 Prompt 丢给它:
请帮我在这台电脑上部署 Strata:github上的/Niko1221/Strata,先阅读并遵循 docs/AI_SETUP.md,检查硬件后使用 Q2_0 权重、32768 上下文,将文件放到【数据盘路径】,完成安装、启动和实际验证,最后把本地模型接入 pi,保留已有配置并告诉我如何启动、停止和切换模型。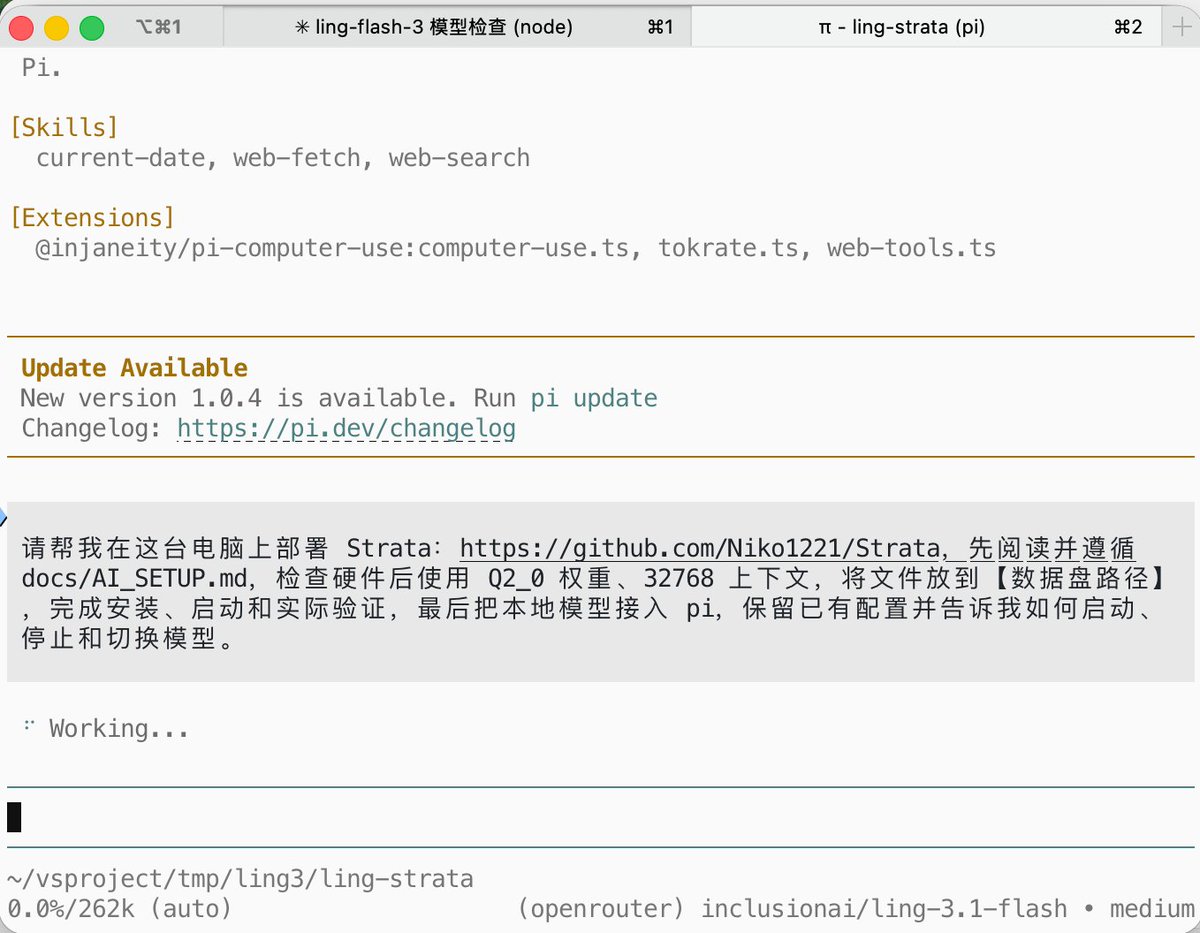
Strata 自己提供了 docs/AI_SETUP.md,所以 Agent 不需要瞎猜流程。
我只要求它最后通过四项验收:
中文正常、GPU 参与、API 成功、pi 能调用。
第一次先开 32K context,确认稳定以后再往上加。
实际跑下来,Ling-3.1-flash最让我满意的是长流程完全没有断。
从读文档、检查环境,到安装、排错、测速、API 验收,它能一直记住前面的状态继续推进。
这种任务,最考验的能不能把活干完干漂亮。
4. 为什么它能跑这么快
了解一下几个名字:
GSQ:把低 bit 权重压得更准。
RCO:把有限的 bit 花在更重要的 tensor 上。
Strata:决定运行时哪些专家放 GPU,哪些留 RAM / CPU。
所以:
GSQ + RCO 负责“压小”,Strata 负责用RAM+GPU跑。
我之前做过一轮 Q2 显存预算实验:
| GPU 专家缓存预算 | Decode | | --- | --- | | 完整缓存 | 159.4 tok/s | | 20GiB | ~131 tok/s | | 16GiB | ~117 tok/s | | 12GiB | ~87 tok/s |
这是在 48GB 4090 上人为限制预算,虽然不等于真实 12GB 卡。
但它说明一个很清楚的规律:
显存越大,热点专家留得越多,CPU miss 越少,速度越快。
5. 这套部署方法以后还能继续用
这次负责部署的是蚂蚁百灵刚推出的Ling-3.1-flash。
几个参数很夸张:
560B 总参数、A25B,最高 1M context。
它本身重点强化的也是代码生成和长流程 Agent 任务,正好适合这次部署:读 Strata 文档、检查环境、执行命令、盯日志、处理报错,最后把本地 Qwen 接回 pi。
Ling-3.1-flash能持续推进一个真实任务直到完成。
而且现在成本基本为零:两周免费试用,每天送 50 万 Token。
它还兼容 Anthropic API,所以除了 pi,也可以直接接进 Claude Code。拿 Key、改几个环境变量,就能把 Claude Code 后面的模型换成 Ling-3.1-flash。
拿 Key、配变量、丢需求,十分钟搞定。
今天我用 560B 的 Ling-3.1-flash,帮我把 125B 的 Qwen 塞进了 12GB 显存。
以后本地模型越来越多,我绝不会学每一个模型怎么装了,让 Agent 自己来。